端到端技术架构

端到端具身交互智能

面向AI 屏幕、机器人与 AR/VR,贯通多模态感知、智脑与多模态表达,形成从环境感知、智脑决策到身体表达执行的完整交互闭环。

星云不是几个能力模块的组合,而是把多模态感知、智脑、多模态表达与行动贯通为一套完整系统。端到端不是一次性的输入与回答, 而是贯通持续感知、持续理解、持续决策、持续表达与行动、持续反馈的持续交互过程。

端到端,而不是拼接

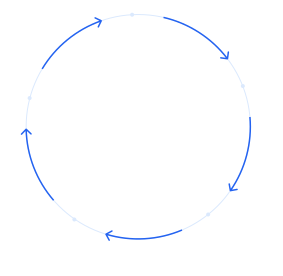
每一步的输出都会进入下一步,并随用户反馈与环境变化持续回到第一步——形成 Continuous Interaction Loop。

传统 · 简单拼接

五项能力各自独立、逐段拼接,打断、延迟与不同步在环节之间不断累积。

ASRLLMTTS
数字人机器人

星云 · 围绕完整用户交互设计的整个系统

Continuous
Interaction Loop

每一步的输出都进入下一步

1.持续感知

语音 · 视觉 · 用户与环境状态

2.持续理解

多模态融合 · 持续交互状态

3.持续决策

专属智脑 · Agent 决策

4.持续表达与行动

多模态表达 · 数字与物理行动

5.持续反馈

用户反馈 · 环境变化

AI 持续感知、理解、表达与行动,并根据用户和环境反馈进入下一轮交互。

端到端带来的价值

01

更自然的交互体验

持续的多模态交互状态,统一、连续、同步的具身表达——AI 在表达的同时,仍然持续感知用户。

更低延迟更自然打断更同步表达更统一状态
02

更短的产品实现路径

快速创建 AI 员工;全栈可插拔——既提供完整产品,也提供开放架构,已有的 ASR、LLM、TTS、RAG 可根据需要复用和替换。

开箱即用全栈可插拔复用与替换开放架构
03

更可控的落地成本与风险

让高质量实时数字人从昂贵的云端能力,变成普通 AI 终端可以大规模部署的基础能力;判断能力成熟度的标准不是 Demo 能不能跑,而是开箱即用、成本可控、远程运维、大规模并发、渠道复制与持续订阅。

更稳定工程更容易规模化
01

多模态感知

持续理解用户当前的交互状态。

多模态感知的最终目标不是声音转文字,或摄像头识别一个人。

语音感知
持续听见真实用户
算法降噪AEC / 抗回声本体声音抑制VADASR远场语音Double Talk智能打断 Barge-in

即使 AI 自己正在说话、机器人正在运动、周围存在噪声,系统依然能够持续听见真实用户。

视觉感知
持续的多模态交互状态
人体检测人脸检测用户识别位置距离注视手势行为表情用户状态多人关系场景理解

从检测与识别,逐步覆盖到注视、行为、表情与多人关系,理解完整场景,最终形成持续的多模态交互状态。

02

专属智脑

将通用模型变成真正属于企业、品牌、岗位或个人的智能体。

让智能体从「会回答」升级为「会做事」。

知识能力
多模态资料与知识
PDF / Word / PPT / 网页 / 图片等多模态资料解析信息抽取知识治理FAQRAG知识更新
智能体能力
身份、任务与决策
身份人设角色任务规则记忆AgentWorkflow对话流程工具调用
企业业务连接
进入真实业务流程
CRMERPOAHISBI商品系统订单系统客户系统门店系统IoT第三方 Agent
专属智脑具身系统能真正工作的智能体
专属智脑决定

这个智能体是谁、知道什么、应该做什么。

具身系统负责

智能体如何感知、表达和行动——具身系统包含感知、表达、行动。

03

多模态表达

统一、连续、同步的具身表达。

让 AI 能够自然地说、看、表达和动作。星云的表达能力不是 TTS + Lip Sync,而是根据当前交互上下文,实时生成和驱动完整的具身表达。

为什么需要具身表达
交流从来不只是文字

真实交流包含语言、声音、语气、情绪、节奏、停顿、眼神、表情、头部动作、手势与身体动作。一个进入现实空间的 AI,不能只是 LLM + TTS,它需要真正拥有具身表达能力。

实时生成与驱动
从输入上下文,到生成与驱动
根据 · 输入上下文
当前语言用户状态智能体角色情绪场景当前交互状态
实时生成和驱动

表达不是预制的播放,而是根据上下文实时生成,并与感知持续同步。

生成与驱动 · 输出模态
语音口型情绪表情眼神头部动作手势身体动作

最终形成——统一、连续、同步的具身表达

04

AI 端渲

让高质量实时数字人成为终端基础能力。

把渲染从昂贵云端搬到普通终端——成本更低、延迟更低、稳定性更高。

让数字人从昂贵云端,来到普通 AI 终端

让高质量实时数字人从昂贵的云端能力,变成普通 AI 终端可以大规模部署的基础能力。

核心价值
COST降低云 GPU 成本渲染在端侧完成,摆脱对云端算力的持续依赖
BANDWIDTH降低带宽不再依赖视频流的长距离传输
LATENCY降低延迟就近渲染,交互链路更短
STABILITY提升稳定性弱网环境下依然可用
OFFLINE支持弱网网络波动不中断实时交互
SCALE支持大规模并发并发不再受云端渲染资源限制
TERMINAL支持低成本 AI 终端对终端芯片要求不高,成本可控
通过端侧实时渲染,降低云 GPU、带宽、延迟与规模化部署成本,让高质量数字人成为 AI 终端基础能力。
工程基础设施定位

在星云的产品体系中,AI 端渲与 Runtime 是关键技术与工程基础设施——它们支撑感知、智脑、表达与行动在终端上真正跑起来。

05

行动与机器人能力

让智能体真正完成任务。

真正的智能体不能只回答问题,还要完成任务。

两层行动
DIGITAL数字行动

发生在数字世界——查询订单与库存、填写表单、创建工单、调用企业系统,完成业务流程。

Agent 调用页面控制系统查询表单办理CRM 操作业务系统连接IoT 控制
PHYSICAL物理行动

发生在物理世界——转向用户、靠近用户、导航带路、执行 Robot Skill、操作现实设备。

转向移动导航带路跟随指示上肢动作Robot Skill物理世界操作

屏幕也有行动,只是主要行动发生在数字世界;机器人则进一步把行动延伸到物理世界。

智能体与身体
多身体统一长期差异化

同一个智能体:在手机上出现 → 进入固定屏 → 进入移动屏 → 进入机器人。智能体持续存在,身体不断升级。

智能体与身体解耦

智能体与身体解耦,同一个智能体可以跨不同终端运行——企业知识、身份、人设、记忆、Agent、任务与业务能力持续复用。

完整的具身交互智能闭环
感知智脑表达行动完整的具身交互智能闭环

核心差异化

端到端技术优势

星云不是几个能力模块的拼接,而是围绕完整用户交互设计的整个系统——每一项差异,都对应一种真实的产品与工程选择。

01端到端,而不是拼接
更低延迟 · 更统一状态 · 更自然打断 · 更同步表达 · 更稳定工程 · 更容易规模化
02持续交互,而不是一问一答
听 · 看 · 理解 · 判断 · 表达 · 行动
03专属智脑,而不是通用 Chatbot
身份 · 知识 · 任务 · 规则 · 业务能力
04具身表达,而不是播放 TTS
语音 · 情绪 · 表情 · 眼神 · 手势 · 身体动作
05AI 端渲
云 GPU · 带宽 · 延迟 · 规模化部署成本
06全栈可插拔
ASR · LLM · TTS · Agent · RAG · 知识库
07多身体统一
智能体持续存在,身体不断升级。
08面向规模化设计
开箱即用 · 成本可控 · 容易部署 · 远程运维 · 大规模并发 · 渠道复制 · 持续订阅

接入与落地

接入与落地:将端到端能力接入你的产品

星云提供从应用配置、效果验证到 SDK 集成的完整接入路径,并支持面向不同终端、业务系统与部署环境进行能力适配。

开发者接入

通过 SDK 和 API,将多模态感知、智脑与多模态表达能力集成至应用。

SDKAPIAgent开发文档
产品与终端适配

面向 AI 屏幕、机器人与 AR/VR,完成终端环境、交互能力与身体执行适配。

终端适配身体适配能力验证岗位模板
企业解决方案

结合企业专属知识、业务流程及部署要求,构建具身交互应用。

专属知识企业业务连接私有化部署产品与模板

让端到端具身交互智能进入更多产品、终端与真实场景

从感知真实世界,到理解交互意图,再到驱动身体完成表达与执行。星云让端到端具身交互智能进入更多产品、终端与真实场景。